
lec11-TCP Congestion Control-II
TCP Reno 的 “Fast Retransmit” 和 “Fast Recovery” 机制 —— 对传统 AIMD 拥塞控制的一次重要改进
dupACK 的意义
当接收方收到乱序的包(例如缺了 #101,但收到了 #102, #103…), 它会不停地 重复发送上一个 ACK(ACK 101), 告诉发送方:“我还在等包 #101”。
于是发送方可以通过“重复 ACK 数量 (dupACKcount)”判断:
| dupACK 数 | 含义 |
|---|---|
| < 3 | 可能只是网络乱序 |
| = 3 | 可以确定丢包,触发 Fast Retransmit |
| > 3 | 表示后续包仍在收到,链路仍可用(不必停顿) |
Fast Retransmit (快速重传)
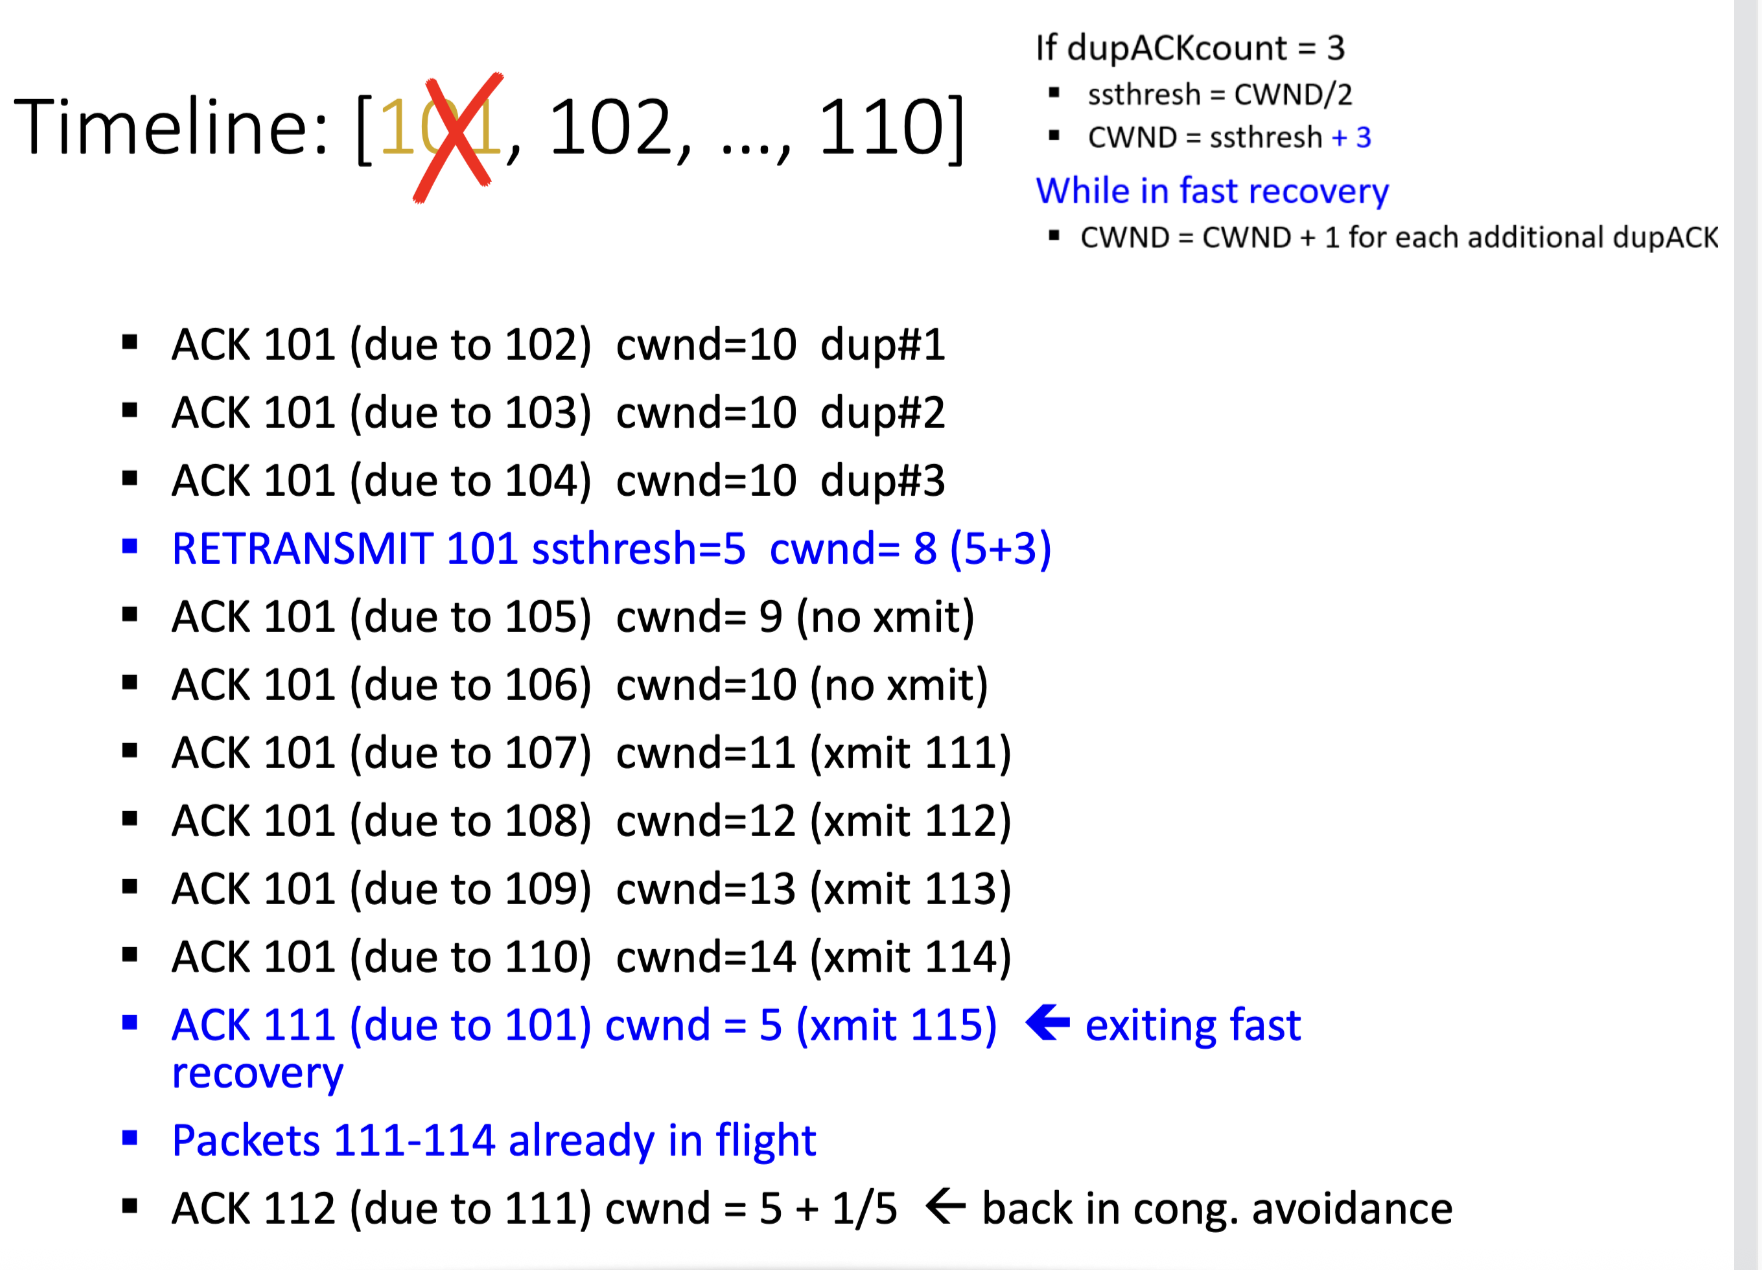
当检测到 dupACKcount = 3:
if dupACKcount == 3:
    ssthresh = CWND / 2
    CWND = ssthresh + 3  # 给3个ACK的“信用额度”
即立即:
-
认为发生丢包;
-
不等超时 (timeout),马上重传丢失的包;
-
进入一个新的状态:“Fast Recovery”。
-
不要立刻进入慢启动或减半停顿, 而是让 sender 临时多发一点包,以保持“管道不空”
-
解释:如果只是单个包丢失,而整个网络其实没拥塞, CWND 减半 → 再线性恢复太慢,会浪费带宽.
因而每个 dupACK 表示接收方已成功收到一个“新包”, 所以可以暂时多发 1 个包,保持 pipeline 满载。
🔹 While in Fast Recovery
每收到一个额外的 dupACK:
CWND = CWND + 1
即每个额外 ACK 允许你再发一个新包。 保持网络持续“被填满”,不进入 idle。
🔹 Exit Fast Recovery
当终于收到“新的 ACK”(即 ACK 111 表示包 101 已成功收到)时:
CWND = ssthresh
即恢复到正常的拥塞避免阶段(linear increase)。
用例:

Timeout -> slowstart
dupACKs -> fast recovery
new ACK 只会在 fast recovery 模式下 changes state.
不同模型的做法
TCP-Tahoe
- CWND =1 on 3 dupACKs
TCP-Reno
- CWND =1 on timeout
- CWND = CWND/2 on 3 dupACKs
TCP-newReno (我们默认使用)
- TCP-Reno + improved fast recovery
TCP-SACK
- Incorporates selective acknowledgements
TCP throughput equation
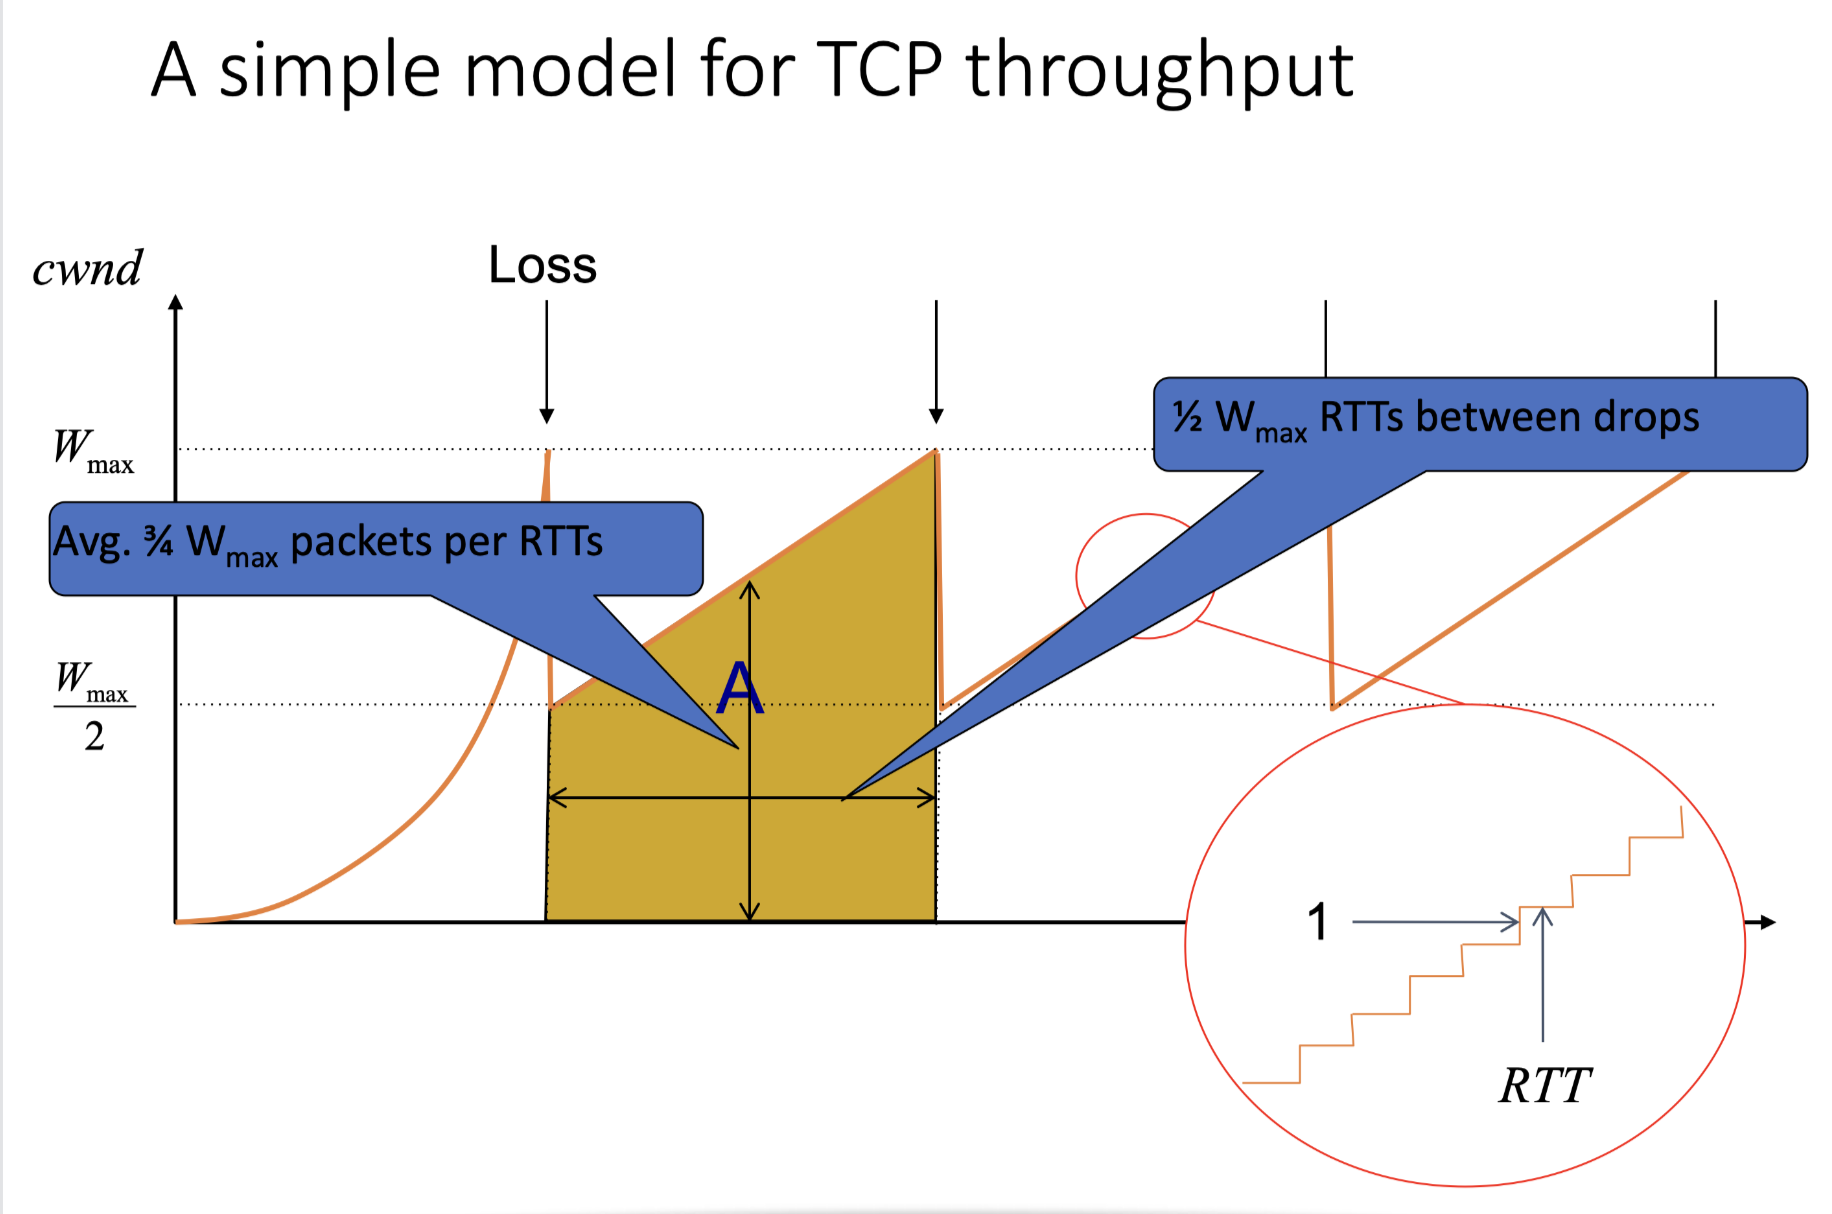
简化模型
这张图假设了:
-
Additive increase:每个 RTT 拥塞窗口 CWND 增加 1;
-
Multiplicative decrease:检测到丢包后 CWND 减半;
-
丢包概率 ( p ) 稳定(即平均每个周期有一次丢包)。
-
窗口从 增加到 ;
-
周期时长约为个 RTT;
-
平均窗口大小约为
于是: $$ 👉 这就是简单模型得出的 “3/2 packets per RTT”。 但它忽略了乘法减小带来的周期性影响。
更精确的模型(包含 multiplicative decrease)
Mathis 等人的理论推导考虑了 AIMD 的完整过程,包括:
- 线性增长(Additive Increase)
- 丢包时的乘法减半(Multiplicative Decrease)
- 丢包概率 ( p )
最终得到: $$
- 实际的窗口曲线并不是完美的三角形;
- 减半与线性增长之间存在平滑过渡;
- 所以平均窗口略小于简单几何平均;
- 精确积分推导引入了
因此,我们常看到的经验公式是: $$
| 模型 | 假设 | 吞吐量表达式 |
|---|---|---|
| 几何近似模型 | 只考虑 Additive Increase | $$ |
| 精确 Mathis 模型 | 含 Multiplicative Decrease | |
| 实际带宽形式 | 含 MSS |
l
求丢包率
我们把公式改为: $$ 代入:
于是: $p \approx 2\times10^{-12}$,平均传 5×10¹¹ 个包才丢 1 个!
求两次丢包之间的时间
一个完整的 “AIMD 循环” 持续时间大约是 个 RTT。
又有: $RTT=0.1, p=2\times10^{-12}$ 所以两次丢包之间平均间隔 16.6 小时。
这就是为什么普通的 TCP Reno / NewReno 在高带宽-长时延环境(如卫星、跨洲光缆)中完全不可用。因为要维持高速率,必须要求极低的丢包率。
→ 因此才有后续的 HighSpeed TCP / CUBIC / BBR 等算法,它们改变了 AIMD 的线性增长特性,使得在高带宽网络中能更快地增加窗口
TCP 仍存在的问题
这三页讲的是 TCP 拥塞控制的局限与改进方向,即经典 TCP(Reno/NewReno)在现实应用中的问题,以及后续算法(如 TFRC、CUBIC、BBR)如何尝试解决这些问题。下面我帮你总结成清晰笔记:
Rate-based Congestion Control
TCP 的速率在周期性波动:
- 由于 AIMD(Additive Increase, Multiplicative Decrease),
- 速率在 区间内反复震荡。
对一些应用(例如视频流、语音通话),这种震荡会带来体验问题,它们更希望稳定的吞吐率。
核心思想:Equation-Based CC(基于方程的拥塞控制)
与传统 TCP 的“根据 ACK 和丢包事件逐步调整 cwnd”不同,这种方法:
-
直接用 TCP 吞吐量方程来设速率: $$
-
测量实际丢包率 (p),然后反向计算出应当发送的速率;
-
不再显式模拟加/乘操作(即不按 ACK 来逐步变化)。
优点
- 速率更平滑、适合流媒体;
- 保持与 TCP “友好”(TCP-friendliness)—— 即不会比普通 TCP 流占用更多带宽。
这类算法的代表是 TFRC (TCP-Friendly Rate Control),常用于多媒体传输协议(如 RTP/RTSP)。
Loss not due to congestion?
TCP 的假设是:
“所有丢包都是由于网络拥塞。”
但现实中还有:
- 链路层比特错误(无线网络);
- 路由器转发错误、信号干扰等。
后果 - TCP 无法区分 “拥塞丢包” 与 “非拥塞丢包”,于是:
- 它会误以为网络拥塞了;
- 然后错误地减小 cwnd;
- 吞吐量被错误压低
由于吞吐量公式依赖于 ( p ): $$ 即使丢包来自无线干扰(而非拥塞),TCP 仍会按照公式下降速率
这推动了后来像 TCP Westwood, TCP Veno, TCP BBR 等算法的出现——它们试图用带宽估计或 RTT 变化来区分不同类型的丢包。
Short flows cannot ramp up
在互联网流量中:
- 约 50% 的 TCP 连接只发送 < 1500B 数据;
- 约 80% 小于 100KB。6
(即大部分流非常短,只传一个网页或小图片。)
结果 - 短流根本没机会进入拥塞避免阶段:
- 它们在慢启动 (Slow Start) 阶段就结束了;
- 永远达不到“公平速率”;
- 甚至无法触发 3 次 dupACK(所以无法快速恢复)。
后果
- 一旦丢包,就只能等 timeout(约 500ms);
- 这对网页加载、API 请求等短连接影响极大;
- 使得 flow completion time (FCT) 显著变长。
现实改进
- 针对短流优化的算法(如 Google 的 TCP Fast Open、BBR Startup 模式);
- QUIC 协议也内置了更高效的启动阶段。
非常好,这四页讲的是 TCP 拥塞控制机制在公平性、延迟、作弊可能性、以及可靠性耦合问题方面的更深层含义。下面我帮你整理成连贯笔记(延续之前的编号):
Short flows share long delays
机制来源
- TCP 通过 AIMD(Additive Increase, Multiplicative Decrease)来探测带宽: 它会主动超出带宽上限(overshoot capacity),直到发生丢包为止。
- 这意味着:网络缓冲区会被填满(bufferbloat),从而导致所有流的延迟都变大。
'
'影响
即使是短流(只发几个包),也必须等待前面长流造成的队列积压:
- 队列延迟增加;
- 所有流都受影响;
- 短流“共享”长延迟。
举例
一个传 10 GB 文件的长流,与十个传 100 B 的短流共用瓶颈链路。
- 长流的窗口逐步增大,充满瓶颈队列;
- 短流发出请求时,也必须排在同一个队列中;
- 结果:短流被长流“拖慢”。
结论
Larger flows dominate smaller ones. TCP 设计的“公平”是在长期平均意义上,但短期(特别是短流)体验极差。
cheating
三种“作弊”方法
- 增加 cwnd 比正常更快
- 例如每 RTT 增加 2 MSS、4 MSS。
- 会更快占满带宽。
- 使用更大的初始 cwnd
- 正常 TCP 初始 cwnd ≈ 10 MSS;
- 许多大型公司(例如 CDN 提供商)使用更大初始窗口,以提升首包加载速度(网页首屏优化)。
- 开多个并行连接
- 每个连接都被 TCP 认为是独立流;
- 若瓶颈平均分配带宽,则:
- 1 个连接得到带宽 = C / N;
- 10 个连接 ⇒ 获得约 10 × (C / N)。
eg:
- A 向 B 开启 10 条连接;
- D 向 E 仅开 1 条;
- 若每条连接平均分得相同带宽, 则: $$
CC intertwined with reliability
TCP 同时提供:
- 可靠传输(基于 ACK + 重传);
- 拥塞控制(基于窗口 + 丢包反馈)。
但两者共用同一套机制(ACK、timeout),强耦合。
- cwnd 调整依赖于 ACK 与超时;
- 累计 ACK(cumulative ACK) 与 快速重传 绑定;
- 修改或分离两者极其困难(例如从 cumulative 改成 selective 需要改动核心机制)。
问题与需求
- 有些应用希望 拥塞控制但不需要可靠性 → 如实时音视频(可以丢帧但不能卡)。
- 另一些希望 可靠性但不需要拥塞控制 → 如局域网内同步或数据中心内部传输(延迟可控)。
由于 TCP 无法轻易解耦可靠性与拥塞控制, 新的传输协议(如 QUIC, DCCP, BBR)开始尝试将两者分离设计:
| 协议 | 拥塞控制 | 可靠性 |
|---|---|---|
| TCP | 强绑定 | 强绑定 |
| DCCP | 有 | 无 |
| QUIC | 可配置 (BBR, Reno, CUBIC) | 应用层可控 |
| UDP | 无 | 无(完全自由) |